Qwen3 全部八个模型参数规格表 — Dense 与 MoE 两大家族完整对照
模型总览
Qwen3 共开源了八个模型规格,分为两个架构家族:
- Dense(密集架构):六个规格,参数从 0.6B 到 32B,每层所有参数在推理时都参与计算
- MoE(混合专家):两个规格,30B-A3B 和 235B-A22B,推理时只激活部分参数
Dense 模型参数表
| 模型 | 层数 | 注意力头 (Q / KV) | 绑定 Embedding | 上下文长度 | 激活参数量级 |
|---|---|---|---|---|---|
| Qwen3-0.6B | 28 | 16 / 8 | 是 | 32K | 约 0.6B |
| Qwen3-1.7B | 28 | 16 / 8 | 是 | 32K | 约 1.7B |
| Qwen3-4B | 36 | 32 / 8 | 是 | 32K | 约 4B |
| Qwen3-8B | 36 | 32 / 8 | 否 | 128K | 约 8B |
| Qwen3-14B | 40 | 40 / 8 | 否 | 128K | 约 14B |
| Qwen3-32B | 64 | 64 / 8 | 否 | 128K | 约 32B |
参数解读
层数:Transformer 堆叠的 block 数量。层数越多,模型容量越大,但推理成本也越高。0.6B 只有 28 层,32B 有 64 层。
注意力头:多头注意力机制中 Q(Query)和 KV(Key/Value)的头数。KV 头数是 GQA(分组查询注意力)的体现——Q 的头数多于 KV 的头数,KV 头被多个 Q 头共享,在长上下文场景下可以显著减少 KV Cache 的显存占用。
绑定 Embedding:0.6B、1.7B、4B 三个小模型开启了输入 Embedding 和输出 LM Head 的权重绑定(tie weights)。这是小模型的常用技巧,可以减少总参数量、节省显存,且对性能影响很小。
上下文长度:模型单次能处理的最大 token 数。0.6B 到 4B 是 32K,8B 及以上提升到 128K。云端 API 中的旗舰版本(Qwen3-Max、Qwen3-VL-Plus)上下文长度更高,达到 256K,但这部分是云端托管的闭源版本。
MoE 模型参数表
| 模型 | 层数 | 注意力头 (Q / KV) | 专家数 (总 / 激活) | 总参数量 | 激活参数量 | 上下文长度 |
|---|---|---|---|---|---|---|
| Qwen3-30B-A3B | 48 | 32 / 4 | 128 / 8 | 约 30B | 约 3B | 128K |
| Qwen3-235B-A22B | 94 | 64 / 4 | 128 / 8 | 约 235B | 约 22B | 128K |
MoE 参数解读
专家数:每个 MoE 层有 128 个专家子网络,但每次推理只激活其中 8 个。这意味着总参数被"稀释"了——模型可以学习到更丰富的模式,但推理成本只和激活参数相关。
激活参数:MoE 模型推理时实际参与计算的参数量。30B-A3B 总参数 300 亿,但激活参数只有 30 亿,和 8B Dense 模型相当;235B-A22B 总参数 2350 亿,激活参数 220 亿,和 32B Dense 模型相当。
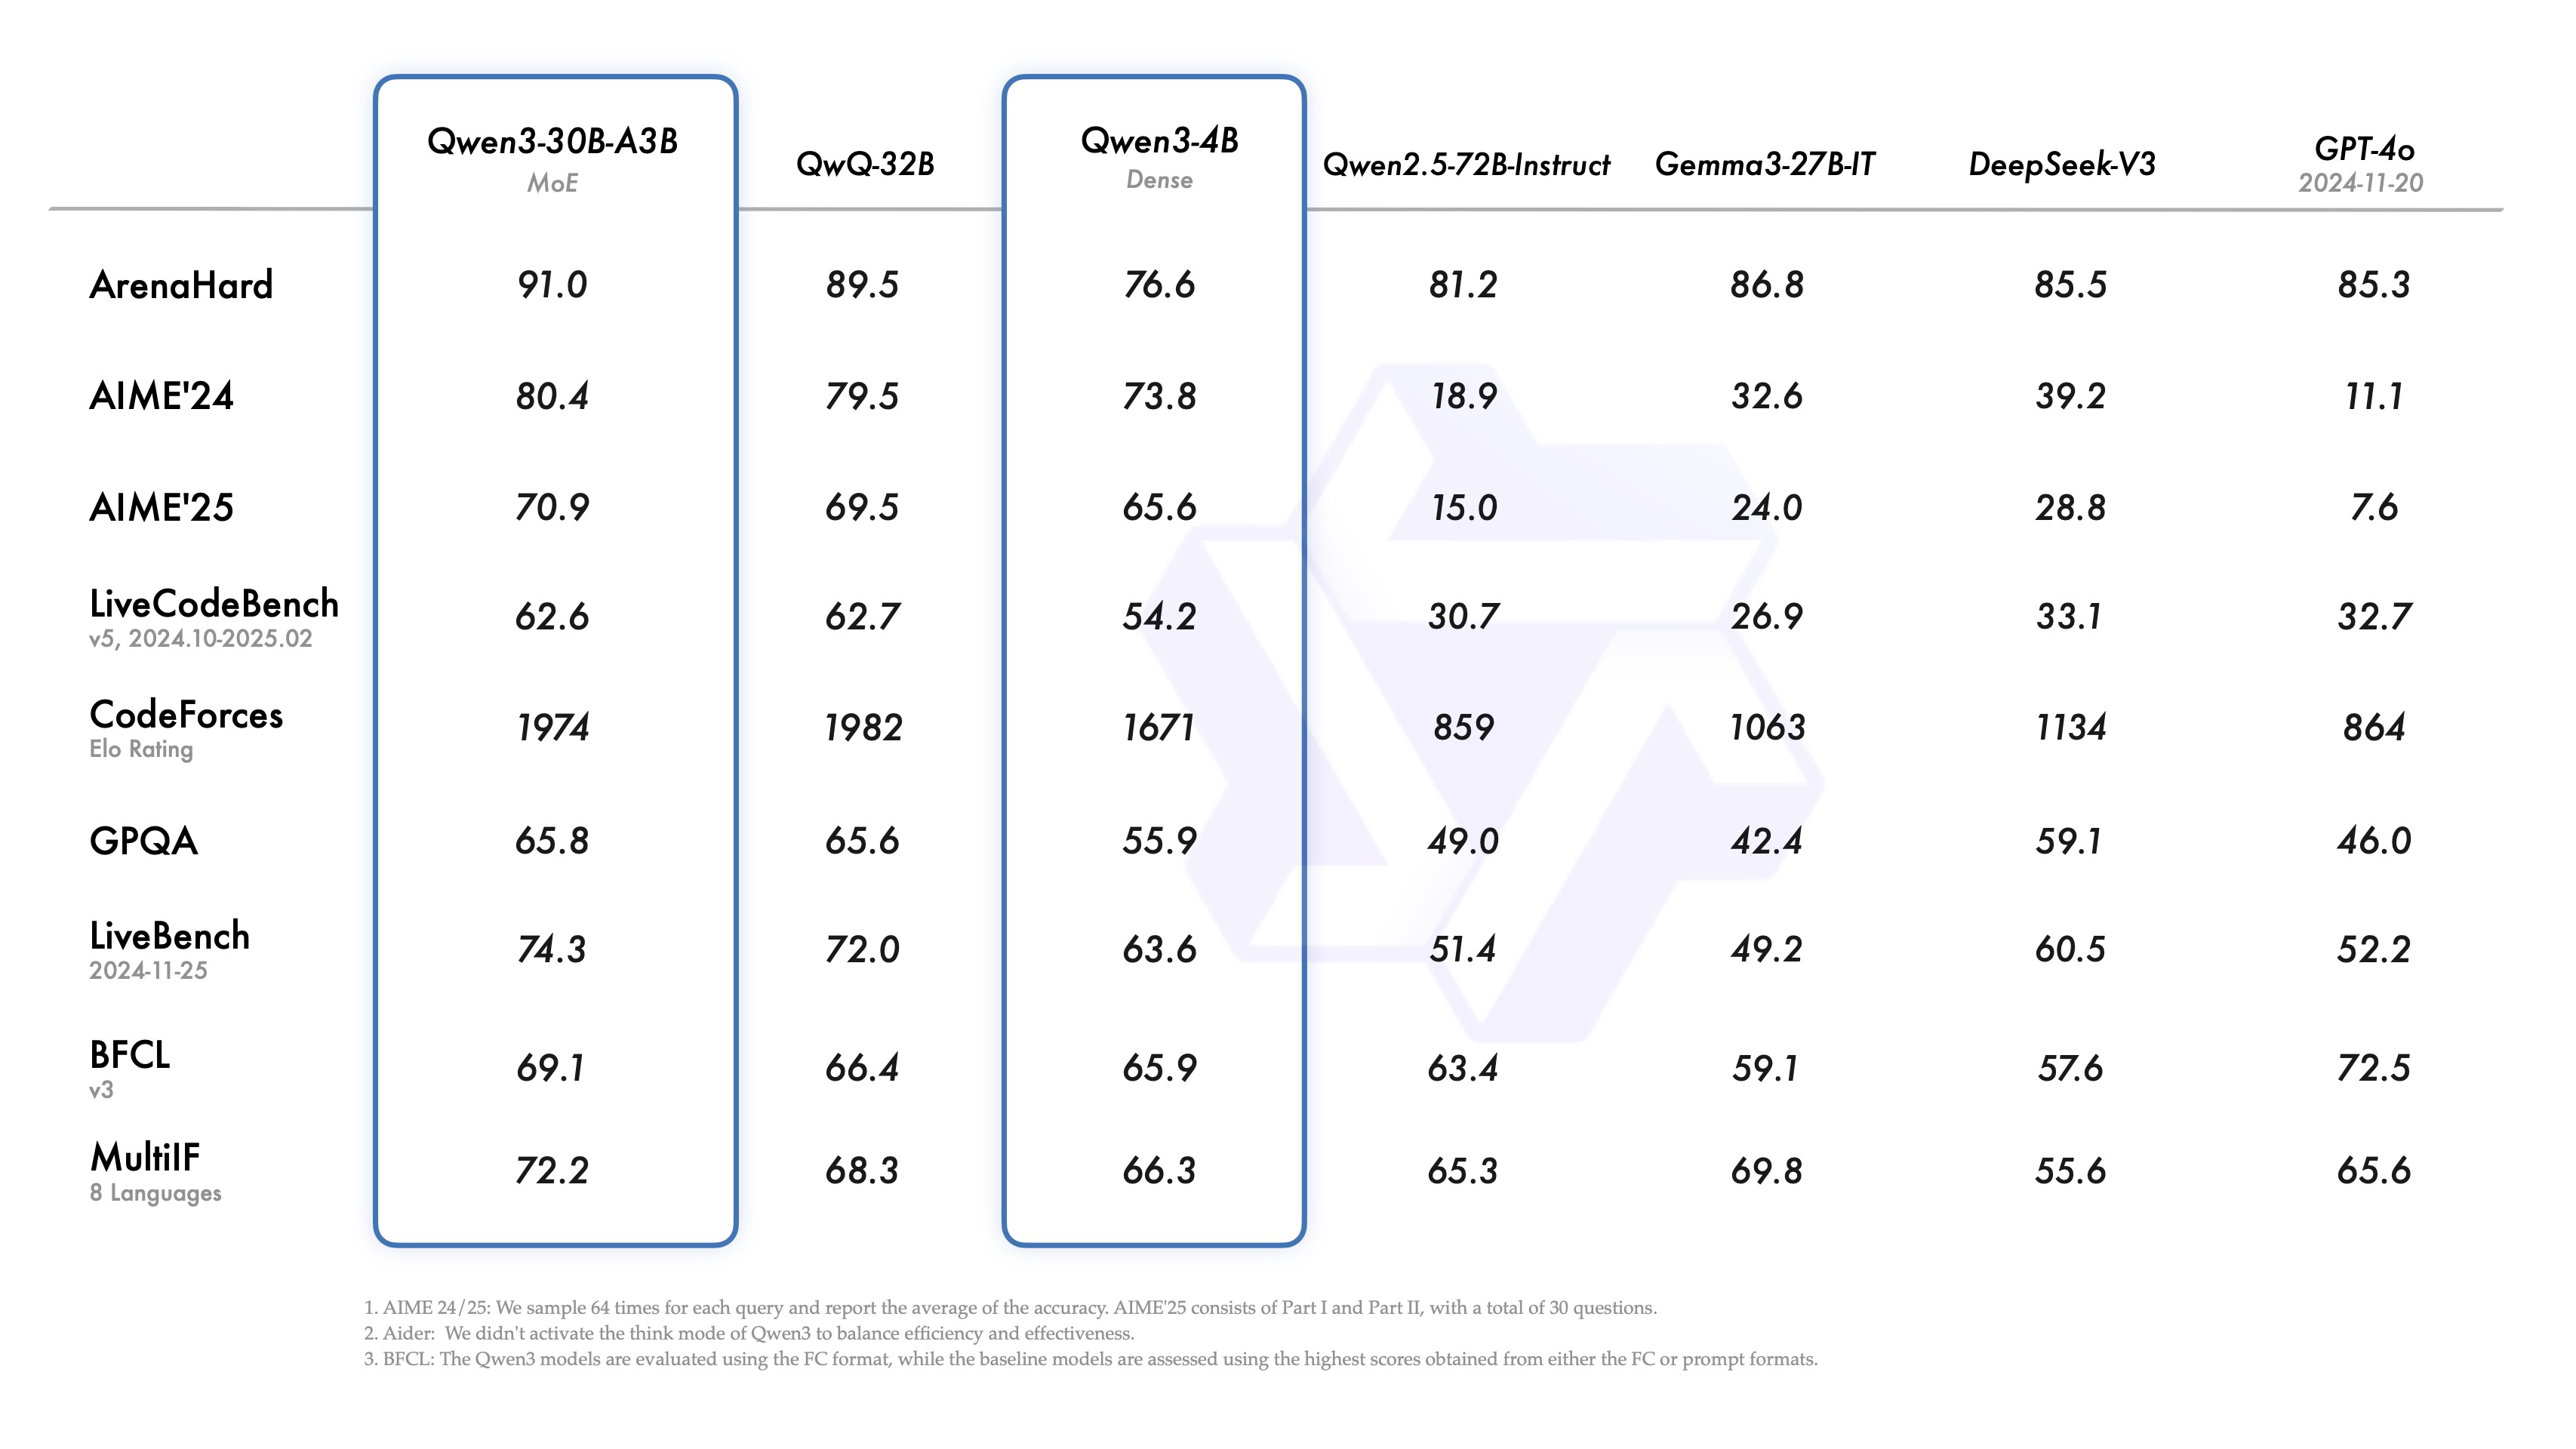
效果:30B-A3B 激活参数只有 QwQ-32B 的 10%,但在多个基准测试上表现更优。235B-A22B 作为当前 Qwen 家族的旗舰模型,在代码、数学、通用能力等基准上与 DeepSeek-R1、o1、o3-mini 等顶级模型竞争。
架构上的统一设计
无论 Dense 还是 MoE,Qwen3 都遵循统一的架构设计:
- GQA(分组查询注意力):所有模型都使用,KV 头数固定为 4 或 8,便于长上下文推理
- RMSNorm:所有归一化层使用 RMSNorm,比 LayerNorm 更高效
- SwiGLU 激活:MLP 层使用 SwiGLU 激活函数
- RoPE 位置编码:所有模型都使用旋转位置编码,支持长上下文泛化
开源权重平台
| 平台 | 链接形式 | 备注 |
|---|---|---|
| Hugging Face | Qwen/Qwen3-8B、Qwen/Qwen3-235B-A22B 等 | 最常用 |
| ModelScope | Qwen/Qwen3-8B | 国内访问快 |
| GitHub | QwenLM/Qwen3 | 技术报告和推理代码 |
| Kaggle | Qwen LM / Qwen 3 | Kaggle Notebook 直接加载 |
相关阅读
- 03-Dense 与 MoE 架构差异:两种架构的技术原理对比
- 04-各尺寸模型选型建议:根据硬件和场景选模型
- 01-Ollama 一键启动:用 Ollama 快速跑起来